آزمون پردازش متن فارسی
ارزیابی دقت OCR فارسی روی اسناد واقعی
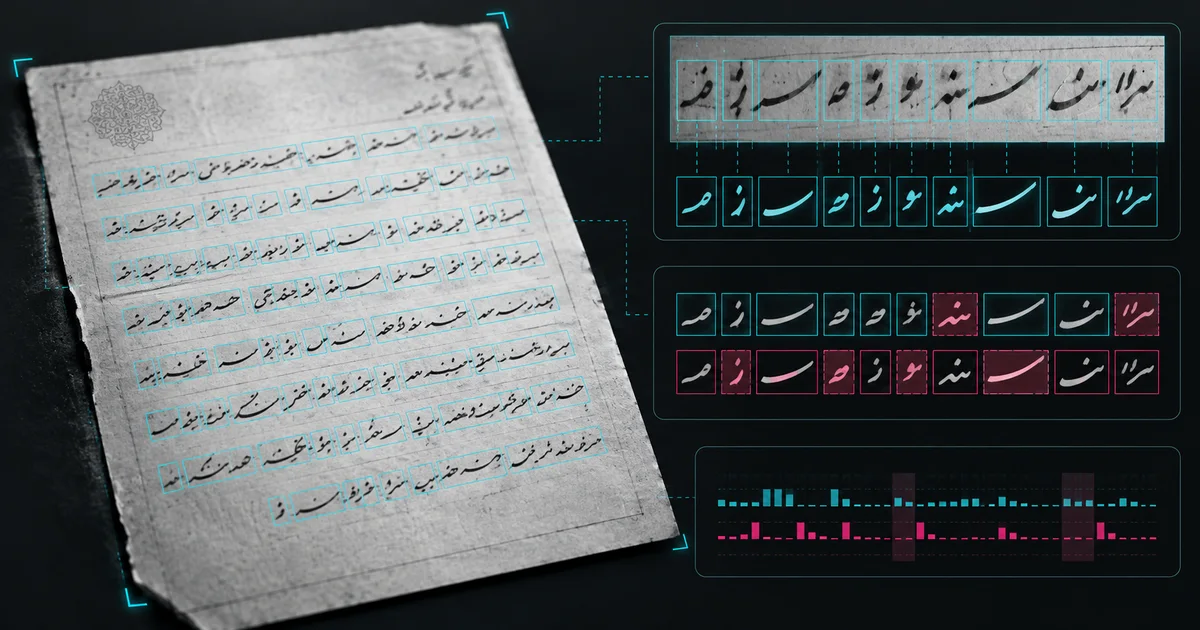
ارزیابی OCR فارسی یعنی خروجی موتور روی نمونه نماینده اسناد واقعی با متن مرجع انسانی مقایسه شود و خطا در نویسه، واژه، فیلد، جدول و چیدمان جدا گزارش شود. اعلام پشتیبانی از کد زبان «fa» فقط امکان پردازش را نشان میدهد؛ دقت عملی به کیفیت اسکن، فونت، فرم، دستنویس، عدد، مهر، جدول و نرمالسازی فارسی وابسته است.
انتشار: · آخرین بهروزرسانی:
نویسنده: تحریریه پیکا — پژوهش و ویرایش با کمک ابزارهای هوش مصنوعی؛ مسئولیت انتشار با پیکا است
روش پژوهش، استفاده از AI و اصلاح محتوا
ارزیابی OCR فارسی یعنی خروجی موتور روی نمونه نماینده اسناد واقعی با متن مرجع انسانی مقایسه شود و خطا در نویسه، واژه، فیلد، جدول و چیدمان جدا گزارش شود. اعلام پشتیبانی از کد زبان «fa» فقط امکان پردازش را نشان میدهد؛ دقت عملی به کیفیت اسکن، فونت، فرم، دستنویس، عدد، مهر، جدول و نرمالسازی فارسی وابسته است.
چرا یک فایل تمیز برای سنجش OCR کافی نیست؟
راهنمای تفاوت OCR، IDP و RAG مرز تبدیل تصویر به متن و استخراج ساختاری را روشن میکند. دقت روی PDF دیجیتال با نامه فکسشده، فرم کپیشده یا تصویر موبایل یکسان نیست. مجموعه آزمون باید توزیع واقعی ورودی را حفظ کند: سازمان، سال، دستگاه، وضوح، چرخش، فونت، دستنویس، جدول، مهر و ترکیب فارسی با عدد و لاتین.
- PDF متنی و اسکن تصویری
- نامه تایپی با فونت و کیفیت مختلف
- فرم دارای جدول، کادر و checkbox
- فاکتور و سند دارای عدد و واحد پول
- مهر، امضا، یادداشت و دستنویس
- صفحه چرخیده، تار، کمنور یا بریده
- متن دو زبانه و شناسه لاتین
- نسخههای قدیمی و کپی چندنسلی
متن مرجع یا Ground Truth چگونه ساخته میشود؟
متن مرجع باید از روی تصویر و با دستورالعمل ثابت رونویسی شود؛ نه با اصلاح خاموش خروجی همان OCR. دو بازبین برای نمونه حساس و ثبت اختلاف، اعتماد مرجع را بالا میبرد. تصمیم درباره فاصله، نیمفاصله، سطر، اعداد، نشانهها، «ی/ي» و «ک/ك» باید پیش از برچسبگذاری نوشته شود. نسخه تصویر، مرجع و قواعد نرمالسازی کنار هم نگه داشته میشوند.
CER و WER چه چیزی را نشان میدهند؟
Character Error Rate تعداد حذف، درج و جایگزینی نویسه را نسبت به طول متن مرجع میسنجد؛ Word Error Rate همین منطق را در سطح واژه به کار میبرد. NIST IR 8199 فاصله ویرایشی نویسه و واژه را برای ارزیابی تشخیص متن توضیح میدهد. CER برای تفاوتهای کوچک مناسب است و WER اثر آن خطاها بر واژه قابل استفاده را بهتر نشان میدهد؛ هر دو باید با مثال شکست همراه شوند.
| خروجی | معیار اصلی | چرا |
|---|---|---|
| متن کامل | CER و WER | شدت خطای نویسه و واژه |
| فیلد فرم | Precision، Recall و exact match | استخراج درست مقدار هدف |
| جدول | صحت سلول، سطر و رابطه | حفظ ساختار نه فقط متن |
| جستوجو | Recall بازیابی پس از OCR | اثر خطا بر یافتن سند |
| ثبت خودکار | نرخ فیلد بدون بازبینی | ارزش عملی و ریسک عملیات |
نرمالسازی فارسی قبل از امتیازدهی چگونه انجام میشود؟
دو گزارش بسازید: خام و نرمالشده. در نسخه نرمالشده میتوان گونه عربی و فارسی ی و ک، فاصلههای تکراری و نمایش یکسان اعداد را طبق نیاز کاربرد همسان کرد؛ اما نباید خطایی را پنهان کرد که در سامانه مقصد معنی دارد. برای نام، مبلغ، تاریخ، کد ملی یا شماره نامه، مقایسه دقیق فیلد جداگانه ضروری است.
کیفیت تصویر و پیشپردازش چگونه مقایسه میشوند؟
مستندات Google Document AI عیبهایی مانند تاری، نویز، تاریکی، متن ریز، بریدگی و glare را بهعنوان عوامل کیفیت تصویر گزارش میکند. چرخش، deskew، حذف نویز، افزایش وضوح یا برش باید بهصورت نسخه آزمایش ثبت شوند. هر پیشپردازش را روی همان test set با خط پایه مقایسه کنید؛ بهبود اسناد ضعیف ممکن است متن ظریف یا مهر را در گروه دیگر خراب کند.
فیلد، جدول و چیدمان چگونه ارزیابی میشوند؟
برای استخراج فیلد، پیشبینی با annotation مرجع تطبیق و Precision، Recall و F1 محاسبه میشود. Google Document AI این معیارها و اثر confidence threshold را مستند میکند: آستانه بالاتر معمولاً precision را زیاد و recall را کم میکند. برای جدول، فقط وجود واژه کافی نیست؛ تعلق مقدار به ستون و سطر، ادغام سلول و ترتیب خواندن باید درست باشد. پایلوت Document AI باید معیار پذیرش را تا این سطح ببرد.
دقت OCR چگونه به نتیجه کسبوکار وصل میشود؟
اگر هدف فقط جستوجو است، باید اثر OCR بر پیدا شدن سند در جستوجوی سازمانی سنجیده شود. اگر هدف ثبت فاکتور است، نرخ فیلد درست، زمان اصلاح و خطای مالی مهمتر از WER متن کاملاند. در ارزیابی RAG، خطای OCR ممکن است استناد یا بازیابی را خراب کند؛ مجموعه سؤال باید روی اسناد OCRشده و متن مرجع اجرا شود.
معیار پذیرش OCR فارسی چگونه تعیین میشود؟
یک درصد عمومی برای همه پروژهها معتبر نیست. دسته سند، فیلد، کیفیت ورودی و هزینه خطا را جدا کنید و برای هرکدام آستانه عبور، مسیر بازبینی و نمونه شکست تعریف کنید. confidence موتور جای معیار صحت نیست؛ باید کالیبره شود تا آستانه ارجاع به انسان بر اساس ریسک تنظیم شود. نسخه موتور و تاریخ آزمون نیز ثبت میشوند چون سرویس ابری ممکن است تغییر کند.
- طبقهبندی ورودی انواع سند و سهم واقعی هر گروه را مشخص کنید.
- نمونهگیری نمونه تصادفی و موارد دشوار را بدون انتخاب نتیجهپسند جمع کنید.
- مرجعسازی متن، فیلد و ساختار را با دستورالعمل و بازبینی ثبت کنید.
- خط پایه خروجی خام را با CER، WER و معیار فیلد بسنجید.
- آزمایش تغییر زبانhint، پیشپردازش و موتور را یکییکی مقایسه کنید.
- گیت عملیاتی آستانه خودکار، بازبینی و توقف را بر اساس هزینه خطا تعیین کنید.
آیا پشتیبانی رسمی فارسی یعنی OCR دقیق است؟
خیر. پشتیبانی یعنی زبان قابل پردازش است؛ دقت باید روی فونت، کیفیت، قالب و اسناد واقعی همان سازمان اندازهگیری شود.
CER بهتر است یا WER؟
هر دو مکملاند. CER خطای جزئی نویسه را نشان میدهد و WER اثر آن بر واژه را؛ برای فیلد حساس exact match و معیار کسبوکاری نیز لازم است.
آیا متن OCR را پیش از ارزیابی نرمال کنیم؟
نسخه خام را حفظ کنید و نسخه نرمالشده جدا بسنجید. قواعد باید از پیش ثابت باشند و خطای معنادار برای سامانه مقصد را پنهان نکنند.
برای اسناد محرمانه از سرویس ابری استفاده کنیم؟
تصمیم به قرارداد، محل پردازش، نگهداری، دسترسی، رمزگذاری و سیاست سازمان وابسته است؛ میتوان پایلوت را با داده ناشناس یا محیط کنترلشده آغاز کرد.
OCR فارسی را روی سند خودتان بسنجید پیکا میتواند نمونهگیری، متن مرجع، گزارش CER/WER و معیار فیلد و بازبینی انسانی را برای یک پایلوت محدود طراحی کند. درخواست ارزیابی OCR
چه زمانی این صفحه پاسخ شما نیست؟
اگر بهجای این راهنمای جامع به موضوع نزدیکتر، دامنه محدودتر یا مرحله اجرایی دیگری نیاز دارید، صفحه «جایگزین پیشنهادی» مسیر دقیقتری ارائه میکند. برای انتخاب از میان همه موضوعها نیز فهرست بلاگ را ببینید.
منابع این مقاله چه زمانی بررسی شدهاند؟
منابع زیر برای کنترل تعریفها، معیارها و نکتههای فنی مقاله بررسی شدهاند؛ تاریخ کنار هر منبع زمان آخرین بازبینی آن را نشان میدهد.
- Google Cloud Vision — OCR language support — بررسیشده در 2026-09-11
- Google Cloud Document AI — Evaluate performance — بررسیشده در 2026-09-11
- NIST IR 8199 — Text Recognition Algorithm Independent Evaluation — بررسیشده در 2026-09-11
- Google Cloud Document AI — Enterprise Document OCR — بررسیشده در 2026-09-11
برای ادامه مطالعه کدام مطالب مرتبطاند؟
این مسیرها موضوع مقاله را از زاویه خدمت، معماری یا تصمیم اجرایی تکمیل میکنند و برای بررسی مرحله بعد مناسباند.